

Penggunaan Artificial Intelligence (AI) di lingkungan kerja semakin luas. Perusahaan kini memakai AI untuk chatbot internal, customer service, pembuatan konten, analisis dokumen, pencarian informasi, hingga membantu developer menulis dan memeriksa kode.
Namun, semakin banyak aplikasi dan karyawan yang menggunakan AI melalui API, muncul persoalan baru: biaya token yang sulit dikendalikan.
Pada tahap awal, biaya API mungkin terlihat kecil. Masalah mulai terasa ketika ratusan atau ribuan request dikirim setiap hari. Pertanyaan yang sama dapat diproses berkali-kali, tugas sederhana menggunakan model premium, hingga satu aplikasi yang salah konfigurasi bisa mengirim request jauh lebih banyak daripada seharusnya.
Di sinilah konsep FinOps AI mulai relevan.
Salah satu pendekatan yang dapat digunakan perusahaan adalah memasang AI Gateway di antara aplikasi dan penyedia model AI. Gateway berfungsi sebagai lapisan kontrol yang membantu perusahaan memonitor sekaligus mengatur bagaimana request AI diproses.
Dengan strategi caching, rate limiting, spend limit, dan model routing, perusahaan dapat mengurangi pemborosan tanpa harus menghentikan pemanfaatan AI.
Mengapa Biaya API AI Kantor Bisa Membengkak?
Sebagian besar layanan AI berbasis API menghitung biaya berdasarkan penggunaan, misalnya jumlah token input dan output. Karena itu, semakin besar dan kompleks pemakaiannya, semakin besar pula biaya yang berpotensi muncul.
Masalahnya, developer atau pengguna aplikasi internal biasanya tidak melihat biaya tersebut secara langsung.
Bayangkan sebuah perusahaan memiliki chatbot internal yang digunakan 500 karyawan. Setiap karyawan mengirim rata-rata 20 request per hari.
Artinya:
500 × 20 = 10.000 request per hari
Dalam 22 hari kerja, jumlahnya dapat mencapai sekitar:
220.000 request per bulan
Belum lagi jika perusahaan memiliki chatbot customer service, AI untuk marketing, aplikasi HR, AI coding assistant, dan berbagai automasi lainnya.
Biaya dapat semakin tidak efisien ketika semua request langsung dikirim ke model AI tanpa lapisan pengendalian.
Beberapa penyebab yang umum antara lain:
- pertanyaan yang sama diproses berulang kali;
- model mahal digunakan untuk pekerjaan sederhana;
- prompt dan context dikirim terlalu panjang;
- tidak ada batas pemakaian untuk masing-masing aplikasi atau pengguna;
- proses otomatis melakukan request secara berulang;
- tidak tersedia monitoring biaya yang terpusat.
Karena itulah perusahaan sebaiknya tidak hanya bertanya, “Model AI mana yang paling pintar?”, tetapi juga “Bagaimana setiap token AI digunakan secara efisien?”
Apa Itu AI Gateway?
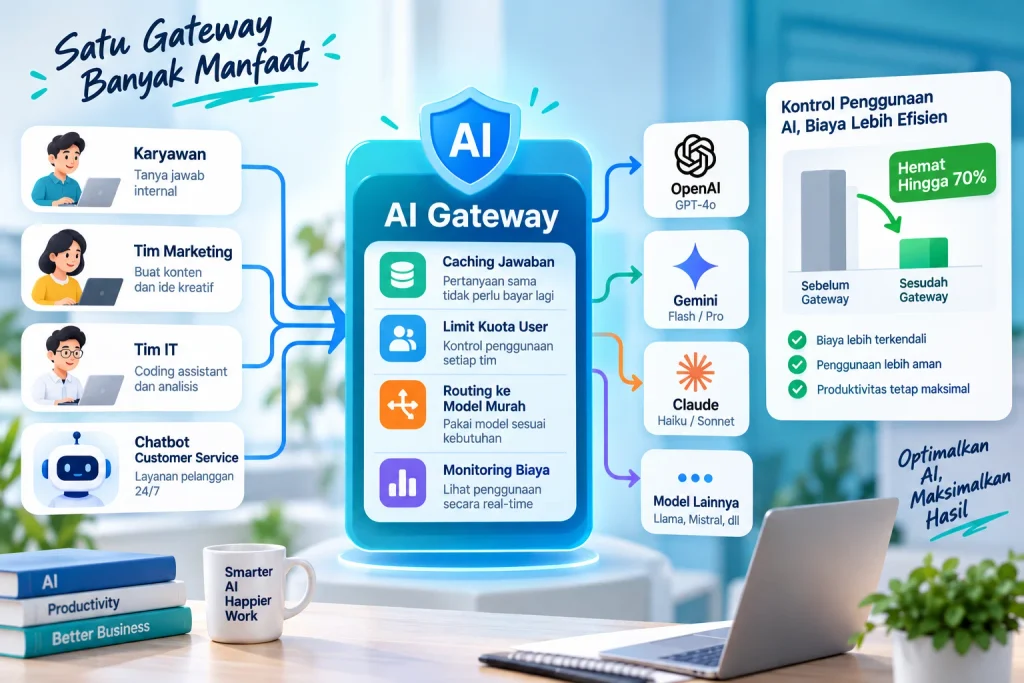
AI Gateway adalah lapisan yang berada di antara aplikasi perusahaan dan penyedia model AI.
Arsitektur sederhana tanpa gateway biasanya terlihat seperti berikut:
User → Aplikasi → API Provider AI → Model AI
Setiap aplikasi berkomunikasi secara langsung dengan provider. Ketika perusahaan memiliki banyak aplikasi, monitoring dan pengendalian biaya menjadi lebih rumit.
Dengan gateway, alurnya berubah menjadi:
User → Aplikasi → AI Gateway → Provider/Model AI
Gateway menjadi pusat lalu lintas request AI.
Sebagai contoh, Cloudflare AI Gateway menyediakan analytics untuk melihat request, token, dan biaya serta fitur seperti caching, rate limiting, logging, fallback, dan routing.
Dengan pendekatan ini, perusahaan tidak harus memperlakukan setiap request AI dengan cara yang sama.
1. Gunakan Caching agar Pertanyaan Sama Tidak Selalu Bayar Lagi
Salah satu sumber pemborosan adalah request yang berulang.
Misalnya chatbot HR sering menerima pertanyaan:
“Bagaimana prosedur pengajuan cuti tahunan?”
Jika 200 karyawan menanyakan hal yang sama, sistem tanpa response cache dapat mengirim request ke model berkali-kali.
Dengan AI Gateway caching, respons untuk request tertentu dapat disimpan. Ketika request identik muncul kembali, gateway dapat memberikan respons dari cache tanpa meneruskannya ke provider.
Cloudflare menjelaskan bahwa caching AI Gateway dapat mengurangi latency sekaligus menghindari request berbayar berulang. Namun, secara default cache bergantung pada request yang identik, sehingga perubahan isi request dapat menghasilkan cache entry berbeda.
Caching cocok untuk kebutuhan yang relatif statis seperti FAQ perusahaan, informasi produk, panduan penggunaan aplikasi, kebijakan internal yang jarang berubah, atau pertanyaan berulang lainnya.
Namun, cache tidak cocok digunakan sembarangan untuk informasi yang bersifat personal atau harus selalu real-time. Perusahaan perlu menentukan TTL dan cache key dengan benar agar pengguna tidak menerima informasi lama atau respons milik konteks yang berbeda.
2. Batasi Request dengan Rate Limiting
Caching saja belum cukup.
Misalnya terdapat script internal yang mengalami bug dan tanpa sengaja mengirim ribuan request dalam waktu singkat.
Tanpa pembatasan, request tersebut dapat tetap diteruskan ke provider dan menambah biaya.
Solusinya adalah rate limiting.
Perusahaan dapat menetapkan aturan seperti:
maksimal 100 request per 60 detik
Ketika batas tersebut dilewati, request tambahan dapat ditolak sementara.
Cloudflare AI Gateway, misalnya, mendukung fixed maupun sliding rate limiting. Request yang melewati batas akan menerima respons HTTP 429 dan tidak diteruskan untuk diproses.
Rate limit sangat berguna sebagai perlindungan terhadap penggunaan berlebihan, lonjakan trafik, script bermasalah, atau automasi yang masuk ke loop.
3. Terapkan Budget atau Spend Limit
Rate limit membatasi jumlah request, tetapi tidak selalu membatasi biaya sebenarnya.
Dua request dapat memiliki biaya yang sangat berbeda.
Request pertama mungkin hanya menggunakan prompt pendek dan model ekonomis. Request kedua bisa membawa context puluhan ribu token dan memakai model premium.
Karena itu, perusahaan juga membutuhkan spend limit.
Cloudflare AI Gateway saat ini memungkinkan perusahaan menetapkan batas biaya berdasarkan model, provider, maupun metadata khusus seperti user, team, atau aplikasi. Ketika batas tercapai, request berikutnya dapat diblokir sampai periode budget kembali tersedia.
Pendekatan ini memungkinkan perusahaan membuat kebijakan seperti:
Tim Marketing → budget AI tertentu/bulan
Tim HR → budget AI tertentu/bulan
Aplikasi Customer Service → budget tersendiri
AI Agent Developer → budget tersendiri
Dengan demikian, bagian keuangan dan IT dapat mengetahui siapa yang menggunakan AI serta berapa biaya yang dialokasikan.
Konsep serupa juga tersedia pada Vercel AI Gateway. Budget dapat diterapkan pada level team, project, API key, maupun user.
4. Jangan Gunakan Model Mahal untuk Semua Pekerjaan
Ini merupakan salah satu prinsip terpenting dalam FinOps AI.
Tidak semua pekerjaan membutuhkan model AI paling canggih.
Misalnya perusahaan mempunyai dua jenis tugas.
Tugas sederhana:
- klasifikasi email;
- ekstraksi kategori;
- merapikan format teks;
- membuat ringkasan pendek;
- menentukan sentimen;
- menjawab FAQ sederhana.
Sedangkan tugas kompleks dapat berupa:
- analisis dokumen panjang;
- reasoning bertahap;
- coding kompleks;
- analisis bisnis;
- pekerjaan agentic yang membutuhkan banyak langkah.
Menggunakan model premium untuk seluruh pekerjaan sederhana dapat meningkatkan biaya tanpa selalu memberikan manfaat yang sebanding.
Solusinya adalah model routing.
Secara konseptual:
Request masuk → AI Gateway → Analisis kebutuhan → Model sesuai kompleksitas
Request sederhana diarahkan ke model yang lebih ekonomis.
Request kompleks baru diteruskan ke model dengan kemampuan lebih tinggi.
Cloudflare mendukung dynamic routing yang dapat menggunakan berbagai kondisi untuk menentukan bagaimana request diarahkan.
Pendekatan cost-aware routing juga digunakan pada AI Gateway lain. Vercel, misalnya, mendokumentasikan pola untuk mengarahkan request mudah ke model murah dan meningkatkan request sulit ke frontier model melalui gateway yang sama.
Dengan demikian, perusahaan tidak perlu memilih antara AI murah atau AI pintar. Keduanya dapat digunakan berdasarkan kebutuhan masing-masing pekerjaan.
5. Bedakan Response Caching dan Prompt Caching
Ada dua istilah yang sering dianggap sama, yaitu response caching dan prompt caching.
Padahal keduanya berbeda.
Response caching pada gateway dapat menyimpan hasil respons sehingga request tertentu tidak perlu diteruskan kembali ke provider.
Sedangkan prompt caching di level provider bekerja dengan memanfaatkan kembali bagian input yang sebelumnya telah diproses.
OpenAI, misalnya, memiliki Prompt Caching untuk mengurangi biaya dan latency pada input berulang yang memenuhi persyaratan caching provider.
Artinya, perusahaan dapat memikirkan optimasi pada beberapa lapisan sekaligus:
Layer 1 — Gateway response caching
Mengurangi kebutuhan melakukan request ulang ke provider.
Layer 2 — Provider prompt caching
Mengurangi biaya pemrosesan bagian prompt berulang ketika request tetap harus diteruskan.
Keduanya dapat menjadi bagian dari strategi optimasi biaya AI yang lebih luas.
6. Pantau Token dan Biaya Berdasarkan User atau Aplikasi
FinOps tidak hanya berarti mengurangi biaya.
Hal yang tidak kalah penting adalah mengetahui ke mana biaya tersebut pergi.
Jika seluruh aplikasi menggunakan satu API key tanpa metadata atau observability yang baik, perusahaan mungkin hanya mengetahui:
“Tagihan AI bulan ini naik.”
Namun perusahaan tidak mengetahui penyebabnya.
Dengan gateway dan metadata yang tepat, monitoring dapat dibuat lebih detail:
| Parameter | Contoh |
|---|---|
| User | user-105 |
| Department | Marketing |
| Application | Internal Chatbot |
| Model | Model A |
| Request | 1.250 |
| Token | 3,2 juta |
| Estimated Cost | sesuai penggunaan |
Data seperti ini membantu perusahaan menemukan aplikasi atau kelompok pengguna yang membutuhkan optimasi.
Cloudflare, misalnya, memungkinkan spend limit dan analytics menggunakan dimensi seperti model, provider, serta custom metadata.
7. Contoh Arsitektur AI Gateway untuk Perusahaan
Arsitektur yang lebih matang dapat dibuat seperti berikut:
Karyawan / Customer
↓
Aplikasi Internal / Website / Chatbot
↓
AI Gateway
↓
Authentication
↓
Rate Limit
↓
Budget Check
↓
Cache Check
↓
Model Router
↙ ↓ ↘
Model Ekonomis | Model Menengah | Model Premium
↓
Logging & Analytics
Dengan arsitektur tersebut, gateway bertindak sebagai pusat kebijakan penggunaan AI.
Developer tidak perlu membuat aturan biaya secara terpisah pada setiap aplikasi.
Simulasi Penghematan dengan AI Gateway
Sebagai ilustrasi sederhana, anggap perusahaan mempunyai 1 juta request AI per bulan.
Misalkan setelah dilakukan analisis ditemukan:
- 20% request merupakan pertanyaan berulang yang layak di-cache;
- 50% merupakan pekerjaan sederhana;
- 30% membutuhkan model yang lebih kuat.
Sebelumnya:
1.000.000 request → semuanya menuju model utama
Setelah optimasi:
200.000 request → cache
500.000 request → model ekonomis
300.000 request → model lebih kuat
Artinya, hanya sebagian request yang membutuhkan pemrosesan menggunakan model kelas atas.
Besarnya penghematan tidak dapat ditentukan hanya dari jumlah request. Hasil akhirnya bergantung pada harga model, panjang input-output, cache-hit rate, dan pola penggunaan sebenarnya.
Namun simulasi tersebut memperlihatkan prinsip utamanya: optimasi dilakukan sebelum request mahal terjadi.
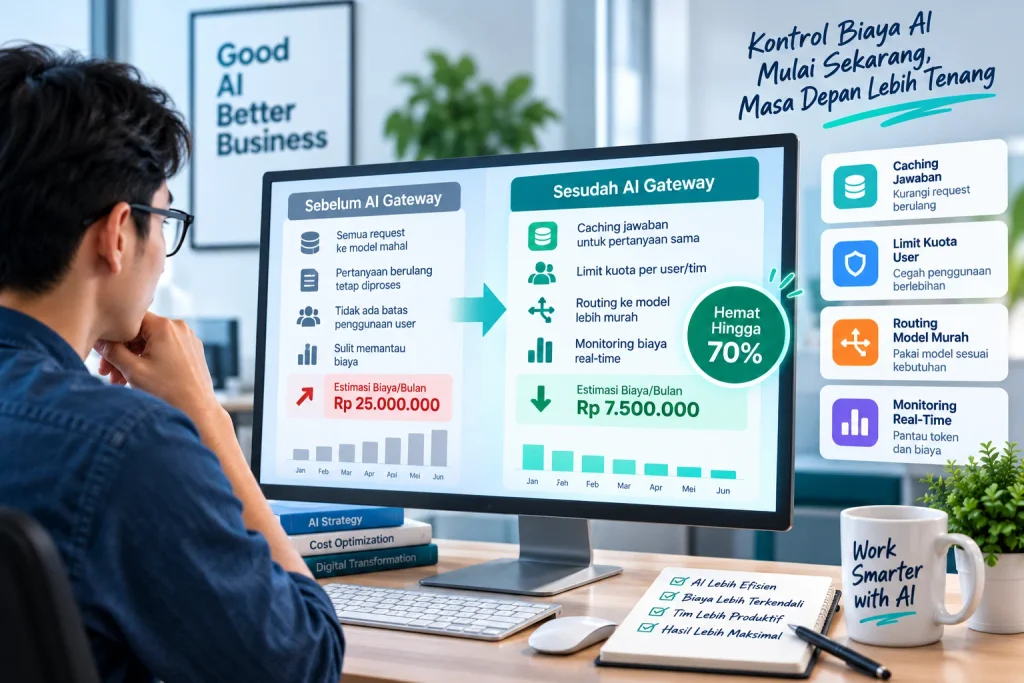
Sebelum vs Sesudah Menggunakan AI Gateway
| Tanpa AI Gateway | Dengan AI Gateway |
|---|---|
| Aplikasi langsung mengakses provider | Request melewati pusat kontrol |
| Pertanyaan berulang tetap diproses | Response tertentu dapat di-cache |
| Semua pekerjaan berpotensi memakai model sama | Model dapat dipilih berdasarkan kebutuhan |
| Sulit mengetahui sumber pemborosan | Penggunaan dapat dimonitor |
| Tidak ada kontrol request terpusat | Rate limiting dapat diterapkan |
| Budget sulit dikendalikan | Spend limit dapat diterapkan |
| Integrasi tersebar | Kebijakan AI lebih terpusat |
Strategi FinOps AI yang Bisa Diterapkan Perusahaan
Perusahaan sebaiknya tidak langsung berfokus pada mengganti model termurah.
Langkah pertama adalah membangun visibility.
Ketahui berapa jumlah request, token, biaya, aplikasi paling aktif, dan model yang paling sering digunakan.
Setelah mempunyai baseline, aktifkan caching pada workload yang aman dan repetitif.
Selanjutnya, terapkan rate limit agar lonjakan penggunaan tidak terkendali.
Tambahkan budget berdasarkan aplikasi, tim, atau user sesuai kebutuhan organisasi.
Kemudian terapkan model routing.
Gunakan model ekonomis sebagai pilihan utama untuk tugas sederhana dan eskalasi ke model lebih kuat hanya ketika diperlukan.
Terakhir, evaluasi penggunaan secara berkala.
AI FinOps bukan pekerjaan sekali selesai. Pola penggunaan AI akan berubah seiring bertambahnya aplikasi, pengguna, agent, dan model baru.
AI Gateway Bukan Sekadar Penghemat Token
Manfaat AI Gateway sebenarnya lebih luas daripada sekadar mengurangi tagihan.
Gateway dapat menjadi control plane penggunaan AI perusahaan.
Tim IT memperoleh observability.
Tim developer mendapatkan satu lapisan integrasi.
Tim finance mendapatkan kontrol biaya.
Sementara perusahaan dapat menetapkan aturan penggunaan AI secara lebih konsisten.
Platform seperti Cloudflare AI Gateway bahkan sudah menyediakan kombinasi caching, spend limits, rate limiting, dynamic routing, analytics, dan logging dalam satu lapisan.
Hal tersebut menunjukkan bahwa pengelolaan AI mulai bergerak dari sekadar persoalan “model mana yang digunakan” menuju “bagaimana seluruh trafik AI perusahaan dikelola.”
Kesimpulan
Adopsi AI di perusahaan dapat meningkatkan produktivitas, tetapi penggunaan API tanpa kontrol dapat membuat biaya token membengkak tanpa disadari.
AI Gateway menawarkan pendekatan yang lebih terstruktur.
Caching dapat mengurangi request berulang. Rate limiting membantu mencegah penggunaan berlebihan. Spend limit menjaga budget setiap aplikasi atau pengguna. Model routing memungkinkan pekerjaan sederhana menggunakan model ekonomis, sementara model premium digunakan ketika benar-benar diperlukan.
Inilah inti dari FinOps AI.
Tujuannya bukan membuat perusahaan menggunakan AI sesedikit mungkin, tetapi memastikan setiap token yang dibayar memberikan nilai yang sepadan.
Ketika penggunaan AI semakin besar, perusahaan yang memiliki observability, budgeting, caching, dan routing yang baik akan lebih mudah meningkatkan skala AI tanpa kehilangan kendali terhadap biaya.
