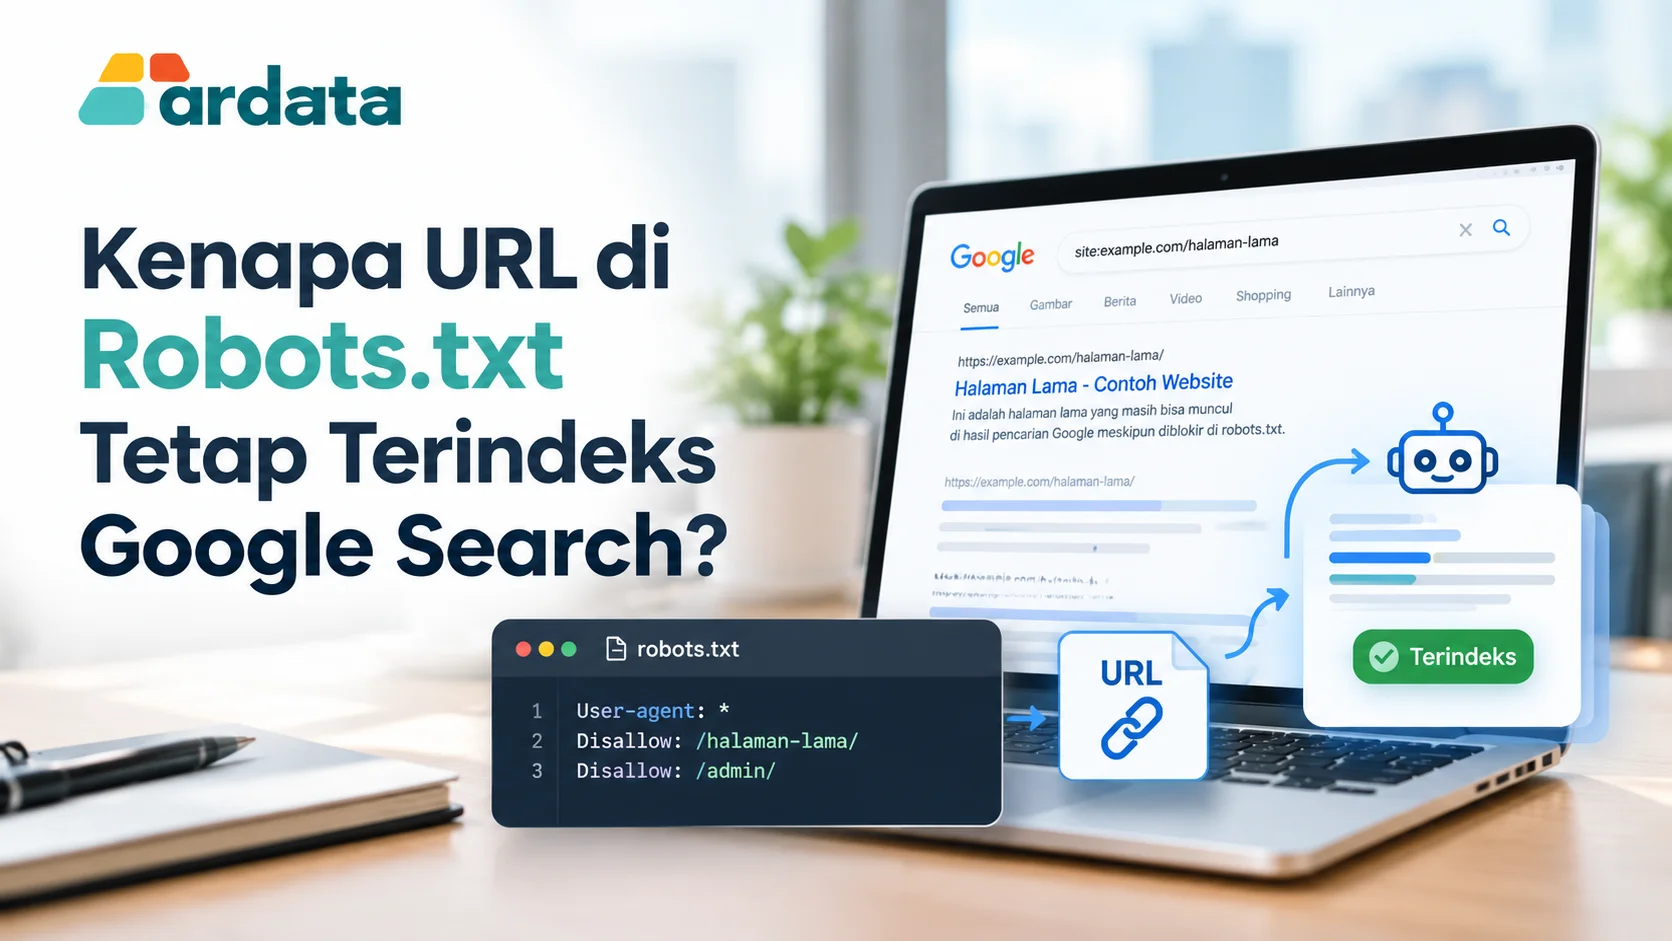
Banyak pemilik website mengira bahwa memasukkan URL ke dalam robots.txt akan membuat halaman tersebut otomatis tidak muncul di Google Search. Kenyataannya, robots.txt memiliki fungsi yang berbeda. File ini digunakan untuk mengatur akses crawler terhadap bagian tertentu dari website, bukan sebagai perintah langsung untuk menghapus URL dari indeks Google.
Itulah sebabnya URL yang sudah diblokir menggunakan aturan Disallow masih dapat muncul di hasil pencarian Google. Google menjelaskan bahwa ketika sebuah URL tidak boleh di-crawl melalui robots.txt, Google mungkin tetap mengetahui keberadaan URL tersebut dan bahkan mengindeks alamat URL-nya, meskipun isi halaman tidak dapat diakses untuk proses crawling.
Table of Contents
ToggleApa Itu Robots.txt?
robots.txt adalah file teks yang ditempatkan pada direktori utama sebuah website. File ini berisi aturan yang memberi tahu crawler mesin pencari bagian mana yang boleh atau tidak boleh di-crawl.
Contoh sederhana:
User-agent: *
Disallow: /admin/
Disallow: /private/
Aturan tersebut memberi tahu crawler bahwa direktori /admin/ dan /private/ tidak boleh diakses untuk crawling.
Namun, penting untuk memahami bahwa crawling dan indexing adalah dua proses yang berbeda.
Robots.txt terutama berhubungan dengan crawling. Sementara itu, indexing merupakan proses ketika Google memproses dan menyimpan informasi mengenai URL untuk digunakan dalam hasil pencarian.
Mengapa URL di Robots.txt Masih Bisa Terindeks?
Google secara eksplisit menjelaskan bahwa URL yang diblokir oleh robots.txt masih dapat diindeks. Dalam kondisi tersebut, Google tidak dapat meng-crawl konten halaman, tetapi URL-nya masih dapat muncul di hasil pencarian, biasanya tanpa informasi lengkap atau snippet dari halaman tersebut.
Misalnya sebuah website mempunyai URL:
https://example.com/halaman-lama/
Kemudian URL tersebut diblokir:
User-agent: *
Disallow: /halaman-lama/
Pemilik website mungkin menganggap masalah sudah selesai. Padahal Google masih bisa mengetahui URL tersebut melalui sumber lain.
Akibatnya, URL dapat tetap berada dalam sistem Google meskipun Googlebot tidak diperbolehkan mengakses halaman tersebut.
Google Bisa Menemukan URL dari Link
Salah satu alasan URL tetap diketahui Google adalah adanya tautan.
Misalnya halaman lain memiliki link:
<a href="https://example.com/halaman-lama/">
    Halaman Lama
</a>
Google dapat menemukan URL tersebut ketika memproses halaman yang mengarah kepadanya.
Link tersebut dapat berasal dari halaman internal website maupun website lain. Karena itu, memblokir crawling melalui robots.txt tidak sama dengan membuat URL tersebut tidak diketahui oleh Google.
Sitemap Juga Dapat Menjadi Sumber URL
Sitemap XML digunakan untuk membantu mesin pencari menemukan URL yang dianggap penting oleh pemilik website.
Contohnya:
<url>
    <loc>https://example.com/halaman-lama/</loc>
</url>
Jika URL yang sama masih tercantum dalam sitemap sementara crawling-nya diblokir melalui robots.txt, terdapat sinyal yang tidak ideal dalam pengelolaan website.
Untuk halaman yang memang tidak ingin diproses atau ditampilkan di Google, sebaiknya tentukan metode pengelolaan URL berdasarkan tujuan sebenarnya, bukan sekadar menambahkan Disallow.
Perbedaan Crawling dan Indexing
Agar masalah ini lebih mudah dipahami, bedakan dua istilah berikut.
Crawling
Crawling adalah proses ketika crawler Google mengakses URL untuk menemukan dan membaca sumber daya pada halaman tersebut.
robots.txt dapat digunakan untuk mengatur apakah crawler diperbolehkan mengakses bagian tertentu dari website.
Indexing
Indexing merupakan proses ketika Google memproses informasi yang ditemukan dan menentukan apakah URL dapat disimpan dalam indeks serta ditampilkan pada hasil pencarian.
Karena kedua proses tersebut berbeda, memblokir crawling tidak otomatis berarti memblokir indexing.
Google menyatakan bahwa URL yang tidak dapat di-crawl karena aturan robots.txt masih dapat muncul dalam hasil pencarian.
Robots.txt Bukan Alat untuk Menghapus URL dari Google
Kesalahan yang cukup sering terjadi adalah menggunakan robots.txt sebagai metode utama untuk menghapus halaman dari Google Search.
Contohnya:
User-agent: *
Disallow: /produk-lama/
Jika tujuannya hanya mengurangi crawling pada area tertentu, aturan tersebut dapat digunakan.
Namun, jika tujuan sebenarnya adalah mencegah halaman muncul di hasil Google, robots.txt bukan metode yang tepat untuk kebutuhan tersebut.
Google sendiri menjelaskan bahwa ketika URL diblokir melalui robots.txt, Google tidak dapat membaca isi halaman tersebut, tetapi masih dapat mengindeks URL-nya.
Gunakan Noindex untuk Mencegah Indexing
Untuk halaman yang masih dapat diakses oleh Google tetapi tidak ingin dimasukkan ke indeks, salah satu metode yang dapat digunakan adalah noindex.
Contohnya melalui meta tag:
<meta name="robots" content="noindex">
Dengan instruksi tersebut, Google dapat mengetahui bahwa halaman tidak ingin diindeks.
Hal yang sangat penting adalah Google harus dapat melakukan crawling terhadap halaman tersebut agar dapat melihat instruksi noindex.
Karena itu, jangan membuat kombinasi seperti:
User-agent: *
Disallow: /halaman-lama/
sementara halaman tersebut juga menggunakan:
<meta name="robots" content="noindex">
Jika Googlebot tidak dapat mengakses halaman akibat Disallow, Google tidak dapat membaca meta tag noindex tersebut. Google juga mengingatkan bahwa halaman yang ingin diperiksa untuk indexing sebaiknya tidak diblokir oleh robots.txt.
Kapan Sebaiknya Menggunakan Robots.txt?
robots.txt lebih cocok digunakan ketika tujuan utamanya adalah mengontrol crawling.
Beberapa contoh penggunaannya antara lain:
- Membatasi crawler agar tidak mengakses area tertentu.
- Mengurangi crawling pada URL atau resource yang tidak diperlukan.
- Mengatur akses crawler terhadap direktori tertentu.
- Mengontrol bagian website yang tidak perlu diproses oleh crawler.
Google menjelaskan bahwa robots.txt digunakan untuk mengatur bagian situs mana yang boleh atau tidak boleh di-crawl oleh crawler.
Namun, penggunaan aturan tersebut harus dilakukan dengan hati-hati karena pemblokiran crawling pada area yang sebenarnya diperlukan Google dapat mengganggu proses pemahaman halaman.
Kapan Menggunakan Noindex?
noindex lebih sesuai ketika tujuan Anda adalah mengatakan kepada mesin pencari:
Halaman ini boleh diakses, tetapi jangan masukkan ke indeks Google.
Contohnya dapat digunakan pada halaman yang memang tidak ingin ditampilkan dalam hasil pencarian tetapi masih diperlukan oleh website.
Hal pentingnya adalah jangan memblokir halaman tersebut dengan robots.txt jika Anda mengandalkan noindex.
Google perlu dapat mengakses halaman untuk membaca instruksi tersebut.
Bagaimana Jika Halaman Sudah Tidak Dibutuhkan?
Jika sebuah halaman benar-benar sudah dihapus dan tidak memiliki pengganti, pendekatan yang berbeda dapat digunakan.
Website dapat mengembalikan HTTP status:
404 Not Found
atau:
410 Gone
Google menyebutkan bahwa 404 atau 410 dapat digunakan untuk halaman yang telah dihapus secara permanen.
Dengan demikian, jangan hanya menambahkan URL yang sudah tidak digunakan ke robots.txt jika tujuan Anda sebenarnya adalah memberi tahu Google bahwa halaman tersebut sudah tidak ada.
Bagaimana Jika Halaman Lama Memiliki Pengganti?
Jika sebuah URL lama telah digantikan oleh URL baru, pengalihan dapat menjadi pendekatan yang lebih sesuai.
Contohnya:
/produk-lama/
dialihkan ke:
/produk-baru/
Dengan begitu, pengunjung yang mengakses URL lama dapat diarahkan ke halaman yang relevan.
Dalam kasus migrasi website, Google juga menekankan pentingnya menangani URL lama dengan benar, termasuk menggunakan status HTTP yang sesuai untuk konten yang memang sudah dihapus.
Cara Mengecek URL yang Tetap Terindeks
Jika menemukan URL yang sudah masuk robots.txt tetapi masih muncul di Google Search, jangan langsung mengubah banyak aturan.
Lakukan pemeriksaan secara bertahap.
1. Cek file Robots.txt
Buka:
https://domainanda.com/robots.txt
Kemudian cari aturan seperti:
User-agent: *
Disallow: /folder/
Pastikan URL yang dimaksud memang termasuk dalam pola Disallow.
2. Periksa URL di Google Search Console
Gunakan URL Inspection di Google Search Console untuk melihat informasi mengenai URL tersebut.
Google menyediakan URL Inspection untuk membantu pemilik website mengetahui bagaimana Google melihat URL tertentu dan apakah halaman dapat diakses atau memiliki masalah indexing.
3. Periksa Apakah Ada Noindex
Jika tujuan Anda adalah mengeluarkan halaman dari Google, periksa apakah halaman memiliki:
<meta name="robots" content="noindex">
atau instruksi X-Robots-Tag pada HTTP response.
Pastikan Google masih dapat mengakses URL tersebut jika Anda menggunakan metode noindex.
4. Periksa Link Internal
Cari apakah halaman lain di website masih mengarah ke URL tersebut.
Misalnya:
Homepage
   ↓
Kategori
   ↓
Artikel lama
Jika artikel lama masih memiliki banyak link internal, Google masih dapat menemukan URL tersebut.
5. Periksa Sitemap
Pastikan URL yang tidak ingin diindeks tidak masih tercantum dalam sitemap yang digunakan website.
Sitemap sebaiknya berisi URL yang memang ingin ditemukan dan diproses oleh mesin pencari.
Bagaimana Menghapus URL yang Sudah Muncul di Google?
Jika URL sudah muncul di hasil Google Search dan perlu segera disembunyikan, Google Search Console menyediakan Removals tool.
Namun, fitur tersebut sebaiknya dipahami sebagai bagian dari proses penghapusan, bukan pengganti tindakan permanen pada halaman.
Untuk penghapusan permanen, Anda tetap perlu menangani URL pada website, misalnya dengan:
- Menghapus halaman dan memberikan status
404atau410. - Menggunakan
noindexjika halaman masih diperlukan tetapi tidak ingin muncul di Google. - Menggunakan autentikasi atau pembatasan akses jika halaman memang harus bersifat privat.
- Menggunakan redirect jika halaman lama memiliki pengganti yang relevan.
Google menyediakan dokumentasi khusus mengenai penghapusan informasi dari hasil Google Search dan penggunaan Search Console untuk proses tersebut.
Kesalahan Umum Saat Mengatur Robots.txt
Ada beberapa kesalahan yang perlu diperhatikan ketika mengelola robots.txt.
Memblokir Semua Halaman
Contoh:
User-agent: *
Disallow: /
Aturan tersebut dapat memblokir crawling pada seluruh website.
Karena itu, jangan menggunakan aturan tersebut pada website produksi kecuali memang memahami konsekuensinya.
Menggunakan Robots.txt untuk Menghapus Index
Disallow bukan perintah noindex.
Fungsi utamanya adalah mengontrol akses crawler, bukan memberikan instruksi langsung bahwa URL harus dihapus dari indeks.
Memblokir URL yang Menggunakan Noindex
Jika URL sudah diberi:
<meta name="robots" content="noindex">
tetapi kemudian crawling URL tersebut diblokir:
Disallow: /halaman/
Google bisa kesulitan membaca instruksi noindex.
Tidak Memeriksa Perubahan Setelah Mengedit Robots.txt
Perubahan kecil pada robots.txt dapat memengaruhi banyak URL sekaligus.
Karena itu, setelah melakukan perubahan, periksa kembali file tersebut dan gunakan alat yang tersedia di Google Search Console untuk memastikan URL penting tetap dapat diakses Google.
Jadi, Mengapa URL di Robots.txt Tetap Terindeks?
Singkatnya, karena robots.txt mengatur crawling, bukan secara langsung mengatur indexing.
Google dapat mengetahui sebuah URL dari link, sitemap, atau sumber lainnya. Ketika URL tersebut diblokir dengan Disallow, Google mungkin tidak dapat membaca isi halaman, tetapi URL-nya masih dapat diketahui dan muncul di hasil pencarian.
Jika tujuan Anda adalah mengontrol apakah Google boleh mengakses halaman, gunakan robots.txt.
Jika tujuan Anda adalah mengontrol apakah halaman boleh masuk indeks, pertimbangkan noindex dan pastikan Google dapat melakukan crawling untuk membaca instruksinya.
Jika halaman memang sudah tidak ada, gunakan status HTTP yang sesuai seperti 404 atau 410. Jika halaman lama memiliki pengganti, pertimbangkan redirect yang relevan.
Dengan membedakan fungsi crawling dan indexing, pengelolaan robots.txt menjadi lebih aman dan masalah URL yang tetap muncul di Google Search dapat ditangani berdasarkan penyebab sebenarnya.