Perkembangan aplikasi berbasis kecerdasan buatan atau artificial intelligence membuat pekerjaan developer berubah cukup signifikan. Jika aplikasi web tradisional umumnya berpusat pada frontend, backend, API, dan database relasional, aplikasi AI modern membutuhkan beberapa lapisan tambahan untuk memahami bahasa, mencari informasi berdasarkan makna, mengelola konteks, sampai menjalankan tindakan secara otomatis.
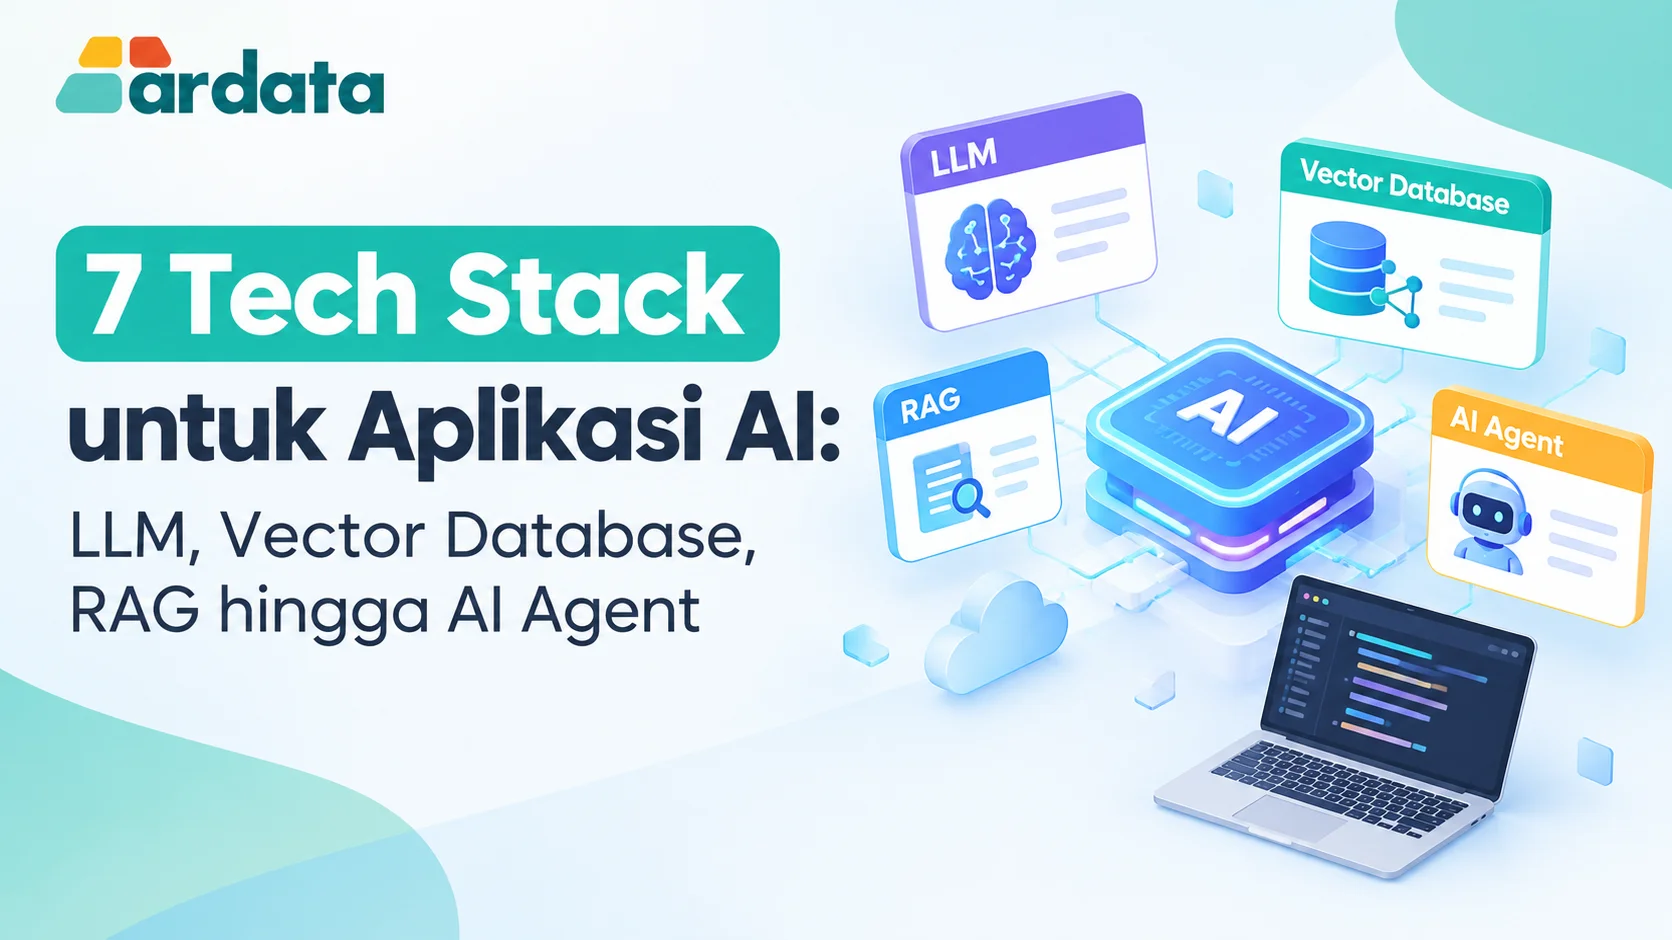
Salah satu pendekatan yang banyak digunakan adalah menggabungkan Large Language Model atau LLM dengan embedding model, vector database, Retrieval-Augmented Generation (RAG), framework orkestrasi, memory system, serta AI agent. Setiap komponen memiliki tugas berbeda, tetapi semuanya saling melengkapi.
LLM, misalnya, dapat menjadi mesin utama untuk memahami pertanyaan dan menghasilkan jawaban. Namun, LLM saja belum tentu mengetahui dokumen internal perusahaan atau informasi terbaru dari database tertentu. Di sinilah embedding, vector database, dan RAG menjadi penting. Sementara itu, ketika aplikasi tidak hanya menjawab pertanyaan tetapi juga harus melakukan tindakan seperti mengambil data, menjalankan API, membuat laporan, atau mengirim permintaan ke sistem lain, kemampuan agent dan tool calling mulai dibutuhkan.
Microsoft menjelaskan RAG sebagai pola arsitektur untuk membuat aplikasi berbasis language model dapat bekerja dengan data spesifik atau proprietary yang belum diketahui model. NIST juga mendefinisikan RAG sebagai sistem yang memasangkan model generatif dengan sistem pencarian atau knowledge base terpisah.
Karena itu, memilih tech stack aplikasi AI bukan sekadar memilih model AI yang paling populer. Developer perlu memahami bagaimana setiap lapisan bekerja, kapan teknologi tertentu diperlukan, dan bagaimana seluruh komponen tersebut dihubungkan menjadi aplikasi yang dapat digunakan di dunia nyata.
Table of Contents
Toggle1. Foundation Model dan LLM sebagai Otak Utama Aplikasi AI
Foundation model adalah model AI yang telah dilatih pada data dalam skala besar dan dapat digunakan sebagai dasar untuk berbagai tugas. Salah satu jenis foundation model yang paling populer untuk aplikasi AI berbasis bahasa adalah Large Language Model atau LLM.
Secara sederhana, LLM dapat dianggap sebagai mesin yang menerima instruksi atau konteks kemudian menghasilkan keluaran berdasarkan kemampuan model tersebut. Keluaran dapat berupa jawaban dalam bahasa natural, ringkasan, klasifikasi, ekstraksi informasi, kode program, atau struktur data tertentu.
Dalam arsitektur aplikasi AI, LLM biasanya berada di lapisan paling penting karena komponen lain pada akhirnya dapat menyediakan informasi atau kemampuan tambahan kepada model.
Fungsi LLM dalam aplikasi AI
LLM dapat digunakan untuk berbagai kebutuhan, seperti:
- Memahami pertanyaan pengguna.
- Membuat jawaban dalam bahasa natural.
- Merangkum dokumen.
- Mengekstrak informasi dari teks.
- Mengubah teks menjadi format terstruktur.
- Membantu penalaran terhadap informasi yang diberikan.
- Menghasilkan kode.
- Menentukan tool atau fungsi yang perlu dipanggil.
- Mengubah hasil pencarian menjadi jawaban yang mudah dipahami.
Contoh model yang dapat digunakan untuk membangun aplikasi AI antara lain keluarga model GPT dari OpenAI, Claude dari Anthropic, Gemini dari Google, serta model open-weight seperti Llama dan Mistral.
Namun, penting untuk memahami bahwa LLM bukan database perusahaan. Model tidak otomatis mengetahui data internal seperti katalog produk, SOP terbaru, data pelanggan, dokumen HR, atau isi database privat hanya karena model tersebut memiliki kemampuan bahasa yang kuat.
LLM tidak sama dengan seluruh aplikasi AI
Kesalahan yang cukup umum adalah menganggap bahwa membuat chatbot AI cukup dengan menghubungkan frontend ke API LLM.
Untuk aplikasi sederhana, pendekatan tersebut memang bisa digunakan. Akan tetapi, kebutuhan aplikasi produksi sering kali jauh lebih kompleks.
Misalnya, sebuah perusahaan ingin membuat chatbot internal yang dapat menjawab:
“Berapa batas maksimal reimbursement perjalanan dinas untuk karyawan level tertentu?”
LLM saja mungkin tidak memiliki informasi tersebut. Sistem membutuhkan sumber data internal. Data tersebut harus dicari, diseleksi, kemudian diberikan kepada LLM sebagai konteks.
Di sinilah embedding, vector database, RAG, dan komponen lainnya mulai berperan.
Hal yang perlu diperhatikan ketika memilih LLM
Developer sebaiknya tidak hanya melihat kemampuan model. Beberapa faktor yang perlu dipertimbangkan adalah:
- Kemampuan memahami instruksi.
- Kemampuan reasoning untuk kebutuhan aplikasi.
- Context window.
- Dukungan tool calling atau function calling.
- Kecepatan respons.
- Biaya penggunaan API.
- Kemampuan multimodal jika aplikasi membutuhkan gambar, audio, atau jenis data lain.
- Kebutuhan privasi dan deployment.
- Konsistensi output.
- Kemampuan menghasilkan structured output.
Dengan demikian, LLM sebaiknya dipilih berdasarkan kebutuhan aplikasi, bukan hanya berdasarkan popularitas model.
2. Embedding Model untuk Mengubah Data Menjadi Representasi Vektor
Jika LLM berperan sebagai otak pemrosesan bahasa, embedding model memiliki tugas yang berbeda. Embedding model mengubah informasi seperti teks menjadi representasi numerik yang disebut embedding atau vector.
Cohere menjelaskan embedding sebagai cara untuk merepresentasikan makna teks, gambar, atau informasi dalam bentuk daftar angka. Representasi tersebut kemudian dapat dibandingkan untuk mengetahui tingkat kemiripan semantik antar-informasi.
Contohnya, kalimat:
“Bagaimana cara mengajukan cuti?”
dan:
“Prosedur permohonan izin libur karyawan”
memiliki kata-kata berbeda, tetapi secara makna sangat berdekatan.
Sistem embedding dapat mengubah kedua kalimat tersebut menjadi vektor yang posisinya relatif dekat dalam ruang representasi.
Mengapa embedding penting?
Database tradisional umumnya mencari data berdasarkan struktur atau kecocokan kata. Sementara itu, aplikasi AI sering membutuhkan pencarian berdasarkan makna.
Misalnya pengguna mencari:
“aturan pengembalian barang”
tetapi dokumen perusahaan menggunakan istilah:
“prosedur retur produk pelanggan”.
Pencarian berdasarkan kata secara sederhana mungkin tidak memberikan hasil terbaik. Semantic search menggunakan embedding memungkinkan sistem mencari berdasarkan kedekatan makna.
Microsoft juga menjelaskan bahwa embeddings merupakan representasi numerik dari konsep yang memungkinkan komputer memahami hubungan antar-konsep untuk kebutuhan retrieval.
Contoh embedding model
Beberapa teknologi yang dapat dipertimbangkan antara lain:
- OpenAI embedding models.
- Cohere Embed.
- BGE-M3.
- Model embedding open-source lainnya.
Cohere saat ini mendokumentasikan model Embed yang dapat digunakan untuk teks dan juga data multimodal tertentu. Dokumentasinya menunjukkan bahwa embedding dapat digunakan untuk semantic similarity, semantic search, clustering, dan classification.
Embedding bukan LLM
Keduanya sering dianggap sama karena sama-sama merupakan model AI. Namun fungsi utamanya berbeda.
LLM digunakan untuk memahami instruksi dan menghasilkan output, sedangkan embedding model terutama digunakan untuk mengubah data menjadi representasi numerik yang dapat dibandingkan.
Dalam pipeline RAG, alurnya kira-kira seperti berikut:
Dokumen → Chunking → Embedding → Vector Database
Kemudian saat pengguna mengajukan pertanyaan:
Pertanyaan → Embedding → Similarity Search → Dokumen relevan → LLM
Dengan pola tersebut, embedding menjadi jembatan antara bahasa manusia dan mekanisme pencarian berbasis vektor.
3. Vector Database untuk Menyimpan dan Mencari Informasi Berdasarkan Kemiripan
Setelah dokumen diubah menjadi embedding, sistem membutuhkan tempat untuk menyimpan vector tersebut. Di sinilah vector database digunakan.
Vector database adalah sistem penyimpanan yang dirancang untuk menyimpan representasi vektor dan melakukan pencarian berdasarkan kemiripan atau distance.
Tujuan utamanya bukan sekadar menyimpan angka, tetapi menemukan vector yang paling dekat dengan vector query.
Bagaimana vector database bekerja?
Misalnya perusahaan memiliki 100.000 potongan dokumen.
Setiap potongan dokumen diubah menjadi vector:
Dokumen A → [0.12, 0.54, 0.31, …]
Dokumen B → [0.19, 0.51, 0.30, …]
Dokumen C → [0.83, 0.11, 0.75, …]
Ketika pengguna mengajukan pertanyaan, pertanyaan tersebut juga diubah menjadi vector.
Vector database kemudian mencari vector dokumen yang paling dekat dengan vector pertanyaan tersebut menggunakan metode similarity atau distance tertentu.
Contoh teknologi vector database
Beberapa pilihan yang umum digunakan dalam ekosistem AI antara lain:
- Pinecone.
- Milvus.
- Qdrant.
- Weaviate.
- PostgreSQL dengan pgvector.
Tidak semua aplikasi harus menggunakan database vector khusus.
Untuk aplikasi yang sudah menggunakan PostgreSQL, pgvector dapat menjadi pilihan karena vector dapat disimpan bersama data relasional. Dokumentasi pgvector menunjukkan dukungan untuk exact dan approximate nearest-neighbor search, cosine distance, inner product, L2 distance, HNSW, serta IVFFlat.
Pendekatan ini menarik untuk aplikasi yang ingin mengurangi jumlah sistem database yang harus dikelola.
HNSW dan IVFFlat
Pada skala besar, pencarian vector perlu dioptimalkan.
Salah satu pendekatan yang tersedia di pgvector adalah HNSW atau Hierarchical Navigable Small World. Pendekatan ini menggunakan struktur graph berlapis untuk mempercepat pencarian approximate nearest neighbor.
pgvector juga mendukung IVFFlat. Keduanya memiliki trade-off antara kecepatan, penggunaan resource, dan recall. Dokumentasi pgvector mencatat bahwa HNSW umumnya memiliki trade-off speed-recall yang baik tetapi membutuhkan lebih banyak memori dan waktu pembangunan index dibanding IVFFlat.
Artinya, pemilihan index tidak bisa dilepaskan dari jumlah data dan kebutuhan latency aplikasi.
Vector database tidak menggantikan database relasional
Ini juga penting.
Vector database tidak otomatis menggantikan PostgreSQL, MySQL, atau database relasional lainnya.
Aplikasi bisnis mungkin tetap membutuhkan database relasional untuk:
- Data pengguna.
- Transaksi.
- Produk.
- Pembayaran.
- Hak akses.
- Status pesanan.
Vector database lebih cocok untuk kebutuhan pencarian berbasis representasi semantik.
Karena itu, aplikasi modern sering menggunakan keduanya secara bersamaan.
4. Retrieval-Augmented Generation atau RAG untuk Menghubungkan AI dengan Data Sendiri
RAG merupakan salah satu konsep terpenting dalam pengembangan aplikasi AI modern.
Retrieval-Augmented Generation adalah pendekatan yang menggabungkan proses pencarian informasi dengan generasi jawaban oleh LLM.
NIST menjelaskan RAG sebagai sistem yang memasangkan model generatif dengan sistem retrieval atau knowledge base. Informasi relevan dari knowledge base diberikan kepada model sebagai konteks sehingga model dapat menggunakannya dalam menghasilkan jawaban.
Google Cloud juga menjelaskan tiga tahap dasar RAG sebagai retrieve, augment, dan generate.
Cara kerja RAG
Secara sederhana, RAG dapat dibagi menjadi dua fase besar: indexing dan querying.
Pada fase indexing:
Dokumen → Parsing → Chunking → Embedding → Vector Database
Dokumen yang besar dipecah menjadi bagian-bagian yang lebih kecil. Setiap bagian kemudian diubah menjadi vector dan disimpan bersama metadata yang diperlukan.
Microsoft menjelaskan bahwa pipeline RAG dapat melakukan chunking, enrichment metadata, embedding, dan penyimpanan chunk ke search index.
Ketika pengguna mengirim pertanyaan:
Pertanyaan → Embedding → Retrieval → Dokumen relevan → Prompt + Context → LLM → Jawaban
Dengan demikian, LLM tidak harus mengandalkan pengetahuan yang diperoleh ketika proses training saja.
Chunking menentukan kualitas retrieval
Chunking merupakan bagian yang sering diremehkan.
Jika dokumen dipotong terlalu besar, satu chunk mungkin berisi terlalu banyak informasi yang tidak relevan. Jika terlalu kecil, konteks yang diperlukan bisa terpisah.
Contohnya dokumen SOP perusahaan memiliki bagian:
- Persyaratan.
- Prosedur.
- Batas waktu.
- Pengecualian.
Jika setiap paragraf dipotong secara sembarangan, informasi yang saling berhubungan dapat terpisah.
Karena itu, strategi chunking perlu disesuaikan dengan struktur dokumen dan jenis pertanyaan yang akan diajukan pengguna.
Reranking meningkatkan kualitas hasil pencarian
Vector search tidak selalu menghasilkan urutan dokumen yang ideal.
Karena itu, sistem RAG dapat menambahkan reranking setelah retrieval tahap pertama.
Cohere menjelaskan reranking sebagai proses mengurutkan kembali hasil pencarian berdasarkan relevansi semantik terhadap query. Teknik ini dapat digunakan setelah lexical search maupun semantic/vector search.
Contohnya:
User query → Vector Search → 20 dokumen → Reranker → 5 dokumen paling relevan → LLM
Pendekatan ini dapat membantu ketika jumlah dokumen sangat besar dan sistem perlu memberikan konteks yang lebih relevan kepada LLM.
RAG bukan jaminan bahwa AI selalu benar
RAG dapat meningkatkan grounding, tetapi bukan berarti semua jawaban otomatis benar.
Jika retrieval mengambil dokumen yang salah, LLM tetap dapat menghasilkan jawaban yang salah berdasarkan konteks tersebut.
Microsoft menekankan pentingnya evaluasi pada setiap tahap RAG, termasuk strategi chunking, embedding, konfigurasi search index, jenis retrieval, dan hasil akhir.
Karena itu, sistem RAG produksi sebaiknya memiliki evaluasi retrieval dan generation secara terpisah.
5. Orkestrasi dan Framework AI untuk Menghubungkan Semua Komponen
Semakin kompleks aplikasi AI, semakin sulit mengelola setiap komponen secara manual.
Bayangkan sebuah aplikasi harus melakukan:
- Menerima pertanyaan.
- Memeriksa session.
- Mengubah query menjadi embedding.
- Mencari vector.
- Melakukan reranking.
- Memasukkan context ke prompt.
- Memanggil LLM.
- Menentukan apakah harus menggunakan tool.
- Menjalankan tool.
- Mengirim hasil tool kembali ke LLM.
- Menyimpan memory.
- Menghasilkan jawaban akhir.
Jika seluruh alur dibuat secara manual, kode aplikasi dapat menjadi kompleks.
Framework orkestrasi AI digunakan untuk membantu mengatur alur tersebut.
Contoh framework AI
Beberapa teknologi yang dapat digunakan antara lain:
- LangChain.
- LlamaIndex.
- Semantic Kernel.
- CrewAI.
LangChain, misalnya, menyediakan berbagai tutorial untuk semantic search, RAG agent, SQL agent, data analysis agent, dan workflow AI lainnya. Dokumentasi resminya juga menempatkan LangGraph sebagai bagian dari ekosistem untuk membangun aplikasi agent yang lebih kompleks.
LlamaIndex banyak digunakan untuk menghubungkan LLM dengan data dan retrieval pipeline.
Semantic Kernel dapat digunakan sebagai lapisan orkestrasi untuk menghubungkan model AI dengan fungsi dan sistem aplikasi.
Sementara CrewAI berfokus pada workflow berbasis agent dan multi-agent.
Framework bukan pengganti LLM
Framework orkestrasi sebaiknya dianggap sebagai lapisan penghubung.
Contohnya:
User → Application → LangChain/LlamaIndex → Vector Database → LLM
Framework mengatur bagaimana komponen-komponen tersebut bekerja sama. Model LLM tetap menjadi mesin yang menghasilkan atau memproses output.
Kapan framework dibutuhkan?
Untuk chatbot sederhana yang hanya memanggil satu API LLM, framework besar mungkin belum diperlukan.
Namun ketika aplikasi mulai memiliki:
- RAG.
- Multiple tools.
- Memory.
- Agent.
- Multiple model providers.
- Workflow bercabang.
- Observability.
- Human-in-the-loop.
framework orkestrasi dapat membantu menjaga struktur kode tetap terorganisir.
6. Memory Systems untuk Menjaga Konteks dan Riwayat Interaksi
Aplikasi AI yang hanya menjawab satu pertanyaan tidak selalu membutuhkan memory kompleks.
Namun chatbot, personal assistant, dan AI agent sering perlu mengetahui konteks interaksi sebelumnya.
Contohnya pengguna mengatakan:
“Saya ingin membeli laptop untuk kuliah.”
Kemudian beberapa menit kemudian pengguna bertanya:
“Bagaimana kalau RAM-nya 16 GB?”
Tanpa konteks sebelumnya, sistem mungkin tidak mengetahui laptop yang sedang dibicarakan.
Memory system digunakan untuk mengelola informasi seperti riwayat percakapan, state session, preferensi yang relevan, dan informasi jangka panjang yang memang diperlukan aplikasi.
Short-term memory
Short-term memory biasanya berkaitan dengan konteks percakapan saat ini.
Contohnya:
User → “Saya ingin membuat website toko online.”
AI → “Baik.”
User → “Gunakan Laravel.”
AI perlu mengetahui bahwa “gunakan Laravel” merujuk pada proyek website toko online yang sedang dibahas.
Data semacam ini dapat dikelola melalui conversation history dan context window.
Long-term memory
Long-term memory digunakan untuk informasi yang perlu dipertahankan lebih lama.
Contohnya:
- Preferensi pengguna.
- Konfigurasi proyek.
- Informasi profil yang memang dibutuhkan aplikasi.
- Riwayat tugas.
- Pengetahuan khusus pengguna.
Untuk kebutuhan ini, aplikasi dapat menggunakan database relasional, Redis, vector storage, atau kombinasi beberapa penyimpanan.
Semantic memory
Semantic memory berfokus pada informasi yang dapat dicari berdasarkan makna.
Misalnya pengguna pernah berdiskusi mengenai:
“proyek aplikasi inventaris menggunakan Laravel dan PostgreSQL.”
Kemudian beberapa hari kemudian pengguna bertanya:
“Bagaimana desain database untuk aplikasi saya?”
Sistem memory berbasis semantic retrieval dapat mencari informasi relevan dari riwayat yang disimpan.
Memory harus memiliki batas
Semakin banyak percakapan dimasukkan ke context window, semakin besar pula jumlah token yang diproses.
Karena itu, memory system tidak berarti memasukkan seluruh riwayat percakapan ke setiap request.
Aplikasi dapat melakukan:
- Conversation summarization.
- Context compression.
- Session state.
- Semantic retrieval.
- Metadata filtering.
- Expiration policy.
Dengan pendekatan tersebut, sistem hanya mengambil memory yang benar-benar relevan.
7. AI Agent dan Tools Execution untuk Membuat AI Dapat Bertindak
Perbedaan besar antara chatbot biasa dan AI agent adalah kemampuan melakukan tindakan melalui tools.
Chatbot sederhana:
User → Pertanyaan → LLM → Jawaban
AI agent:
User → Tujuan → Agent → Planning/Reasoning → Tool → Hasil → Agent → Jawaban atau tindakan berikutnya
Tool dapat berupa API, database, fungsi Python, search engine, calculator, sistem internal perusahaan, atau layanan eksternal.
Function calling dan tool calling
Google menjelaskan bahwa function calling memungkinkan model terhubung dengan external tools dan API. Model menentukan kapan fungsi perlu dipanggil dan menghasilkan parameter yang kemudian digunakan aplikasi untuk menjalankan tindakan tersebut.
Contohnya pengguna berkata:
“Berapa total penjualan bulan ini dan buatkan laporan?”
Agent dapat melakukan beberapa langkah:
- Memanggil database penjualan.
- Mengambil data bulan berjalan.
- Menghitung total.
- Membuat ringkasan.
- Menghasilkan laporan.
LLM sendiri tidak harus melakukan seluruh pekerjaan tersebut. Model menentukan langkah dan tool yang dibutuhkan, sedangkan aplikasi menjalankan fungsi sebenarnya.
Agentic RAG
RAG tradisional biasanya memiliki alur yang relatif tetap:
Query → Search → Context → LLM → Answer
Agentic RAG memberikan lebih banyak fleksibilitas.
Agent dapat menentukan:
- Apakah perlu melakukan pencarian.
- Sumber mana yang perlu dicari.
- Apakah harus melakukan beberapa pencarian.
- Apakah query perlu dipecah.
- Apakah hasil pencarian cukup.
- Apakah harus menggunakan tool lain.
Microsoft membedakan standard RAG dan agentic RAG dengan menjelaskan bahwa agentic RAG dapat memperlakukan retrieval sebagai tool yang dipanggil agent ketika dibutuhkan.
AI agent membutuhkan pengamanan
Kemampuan menjalankan tool juga membawa risiko tambahan.
Jika agent memiliki akses ke:
- Database.
- File system.
- Email.
- Sistem pembayaran.
- API perusahaan.
- Command execution.
maka developer harus menerapkan kontrol keamanan.
Beberapa pendekatan yang dapat digunakan antara lain:
- Permission berbasis role.
- Validasi parameter.
- Tool allowlist.
- Sandbox.
- Rate limit.
- Audit log.
- Human approval untuk tindakan berisiko.
- Pembatasan akses database.
- Secrets management.
Semakin besar tingkat otonomi agent, semakin penting mekanisme kontrol tersebut.
Bagaimana Ketujuh Komponen Ini Bekerja Bersama?
Ketujuh komponen di atas sebenarnya dapat dipandang sebagai sebuah pipeline.
Contoh aplikasi adalah chatbot internal perusahaan.
Tahap pertama: data ingestion
Dokumen perusahaan dikumpulkan.
PDF, DOCX, HTML, database, dan sumber lainnya diproses menjadi data yang dapat dicari.
Tahap kedua: chunking dan embedding
Dokumen dipecah menjadi bagian yang relevan.
Setiap bagian kemudian diubah menjadi embedding.
Tahap ketiga: penyimpanan
Embedding dan metadata disimpan di vector database.
Metadata dapat berisi:
- ID dokumen.
- Judul.
- URL.
- Departemen.
- Tanggal.
- Hak akses.
- Nomor halaman.
Tahap keempat: user mengajukan pertanyaan
Pengguna mengirim pertanyaan ke aplikasi.
Pertanyaan kemudian diproses dan dibuat menjadi embedding.
Tahap kelima: retrieval
Vector database melakukan similarity search untuk menemukan dokumen yang relevan.
Jika diperlukan, hasil tersebut dapat diproses kembali menggunakan reranker.
Tahap keenam: orchestration
Framework AI mengatur bagaimana hasil retrieval digabungkan dengan pertanyaan pengguna.
Context kemudian dimasukkan ke prompt LLM.
Tahap ketujuh: generation
LLM menghasilkan jawaban berdasarkan pertanyaan dan konteks yang telah diberikan.
Tahap kedelapan: memory
Jika aplikasi membutuhkan percakapan berkelanjutan, informasi relevan dapat disimpan sebagai session state atau memory.
Tahap kesembilan: agent
Jika pertanyaan membutuhkan tindakan, agent dapat memanggil tool.
Misalnya:
“Ambil data penjualan minggu ini dan bandingkan dengan minggu lalu.”
Agent dapat menggunakan database tool untuk mengambil data kemudian meminta LLM menganalisis hasilnya.
Dengan demikian, sebuah aplikasi AI modern dapat memiliki arsitektur:
User Interface
↓
Backend/API
↓
Orchestration Layer
↓
LLM
↙ ↓ ↘
Memory → RAG → Tools
↓
Embedding → Vector Database
↓
Knowledge Base
Arsitektur sebenarnya dapat berbeda tergantung kebutuhan aplikasi. Tidak semua proyek membutuhkan seluruh komponen sekaligus.
Cara Memilih Tech Stack Aplikasi AI
Tidak semua aplikasi harus menggunakan stack paling kompleks.
Untuk chatbot sederhana, developer dapat memulai dari:
LLM + Backend + Database
Jika chatbot harus menjawab berdasarkan dokumen:
LLM + Embedding + Vector Database + RAG
Jika membutuhkan percakapan berkelanjutan:
LLM + RAG + Memory
Jika harus melakukan tindakan:
LLM + Tools + Agent
Untuk aplikasi enterprise yang kompleks:
LLM + Embedding + Vector Database + RAG + Reranker + Orchestration + Memory + Agent + Observability + Security
Pendekatan bertahap seperti ini lebih masuk akal daripada langsung memasukkan seluruh komponen ke proyek sejak awal.
Hal yang Perlu Diperhatikan Developer
Membangun aplikasi AI bukan hanya persoalan memilih model.
Ada beberapa faktor teknis yang harus diperhatikan.
Kualitas data
RAG tidak akan memberikan hasil baik jika dokumen sumbernya buruk, tidak lengkap, atau tidak terstruktur.
Kualitas retrieval
Jika sistem gagal menemukan dokumen yang tepat, LLM tidak memiliki konteks yang diperlukan.
Context management
Terlalu banyak informasi juga dapat membuat prompt tidak efisien. Sistem perlu memilih context yang benar-benar relevan.
Latency
Setiap komponen tambahan dapat menambah waktu respons.
Misalnya satu request harus melewati embedding API, vector search, reranking, LLM, kemudian tool call. Semua langkah tersebut perlu diperhitungkan.
Biaya
Biaya aplikasi AI dapat berasal dari:
- Token LLM.
- Embedding.
- Vector database.
- Reranking.
- Infrastruktur backend.
- Penyimpanan.
- Observability.
- Tool/API eksternal.
Karena itu, arsitektur harus dirancang sesuai kebutuhan dan volume pengguna.
Evaluasi
Developer sebaiknya menguji sistem dengan kumpulan pertanyaan nyata.
Untuk RAG, evaluasi dapat mencakup apakah dokumen yang relevan berhasil ditemukan dan apakah jawaban akhir benar-benar menggunakan context tersebut. Microsoft secara khusus merekomendasikan pendekatan evaluasi yang sistematis pada setiap tahap RAG.
Perbandingan 7 Tech Stack Aplikasi AI
| Tech Stack | Fungsi Utama | Contoh Teknologi | Peran dalam Aplikasi AI | Cocok untuk |
|---|---|---|---|---|
| Foundation Model / LLM | Memahami instruksi dan menghasilkan output | GPT, Claude, Gemini, Llama, Mistral | Otak pemrosesan bahasa | Chatbot, coding assistant, content generation |
| Embedding Model | Mengubah data menjadi representasi vector | OpenAI Embeddings, Cohere Embed, BGE-M3 | Menjadi dasar semantic search | Search, RAG, recommendation |
| Vector Database | Menyimpan dan mencari vector | Pinecone, Milvus, Qdrant, Weaviate, pgvector | Menemukan informasi berdasarkan kemiripan | RAG, semantic search, knowledge base |
| RAG Pipeline | Mengambil data eksternal dan memberikannya kepada LLM | LangChain/LlamaIndex + vector store + search | Menghubungkan LLM dengan data khusus | Chatbot dokumen, enterprise AI |
| Orchestration & AI Framework | Mengatur alur antar-komponen | LangChain, LlamaIndex, Semantic Kernel, CrewAI | Menghubungkan model, database, memory, dan tools | Workflow AI kompleks |
| Memory System | Menyimpan konteks dan informasi interaksi | Redis, PostgreSQL, vector storage, session store | Mempertahankan konteks pengguna | Assistant, chatbot, personal AI |
| AI Agent & Tools | Menjalankan tindakan melalui tools dan API | Function calling, custom Python tools, agent frameworks, sandbox | Membuat AI dapat mengambil tindakan | Automation, research agent, workflow agent |
Pada akhirnya, tidak ada satu tech stack yang cocok untuk semua aplikasi AI. LLM merupakan pusat pemrosesan, tetapi aplikasi yang membutuhkan pengetahuan eksternal membutuhkan retrieval dan data layer. Embedding serta vector database mendukung proses pencarian berbasis makna, sedangkan RAG menjadi pola yang menghubungkan hasil retrieval dengan LLM.
Untuk aplikasi yang lebih kompleks, framework orkestrasi membantu mengatur alur kerja, memory mempertahankan konteks, dan AI agent memungkinkan sistem menggunakan tools untuk menjalankan tindakan.
Perkembangan aplikasi AI juga menunjukkan bahwa developer semakin perlu memandang AI sebagai sebuah sistem, bukan sekadar sebuah model. Kualitas aplikasi ditentukan oleh kombinasi model, data, retrieval, orchestration, memory, tools, keamanan, latency, biaya, dan evaluasi.
Dengan memahami fungsi setiap layer, developer dapat membangun stack secara bertahap. Mulailah dengan LLM untuk kebutuhan generasi dasar, tambahkan embedding dan vector database ketika aplikasi membutuhkan semantic search, gunakan RAG ketika model harus bekerja dengan data khusus, kemudian tambahkan memory dan agent ketika aplikasi membutuhkan konteks berkelanjutan serta kemampuan menjalankan tindakan.
Pendekatan tersebut membuat arsitektur aplikasi AI lebih mudah dikembangkan sekaligus membantu developer menghindari penggunaan teknologi yang sebenarnya belum dibutuhkan.