

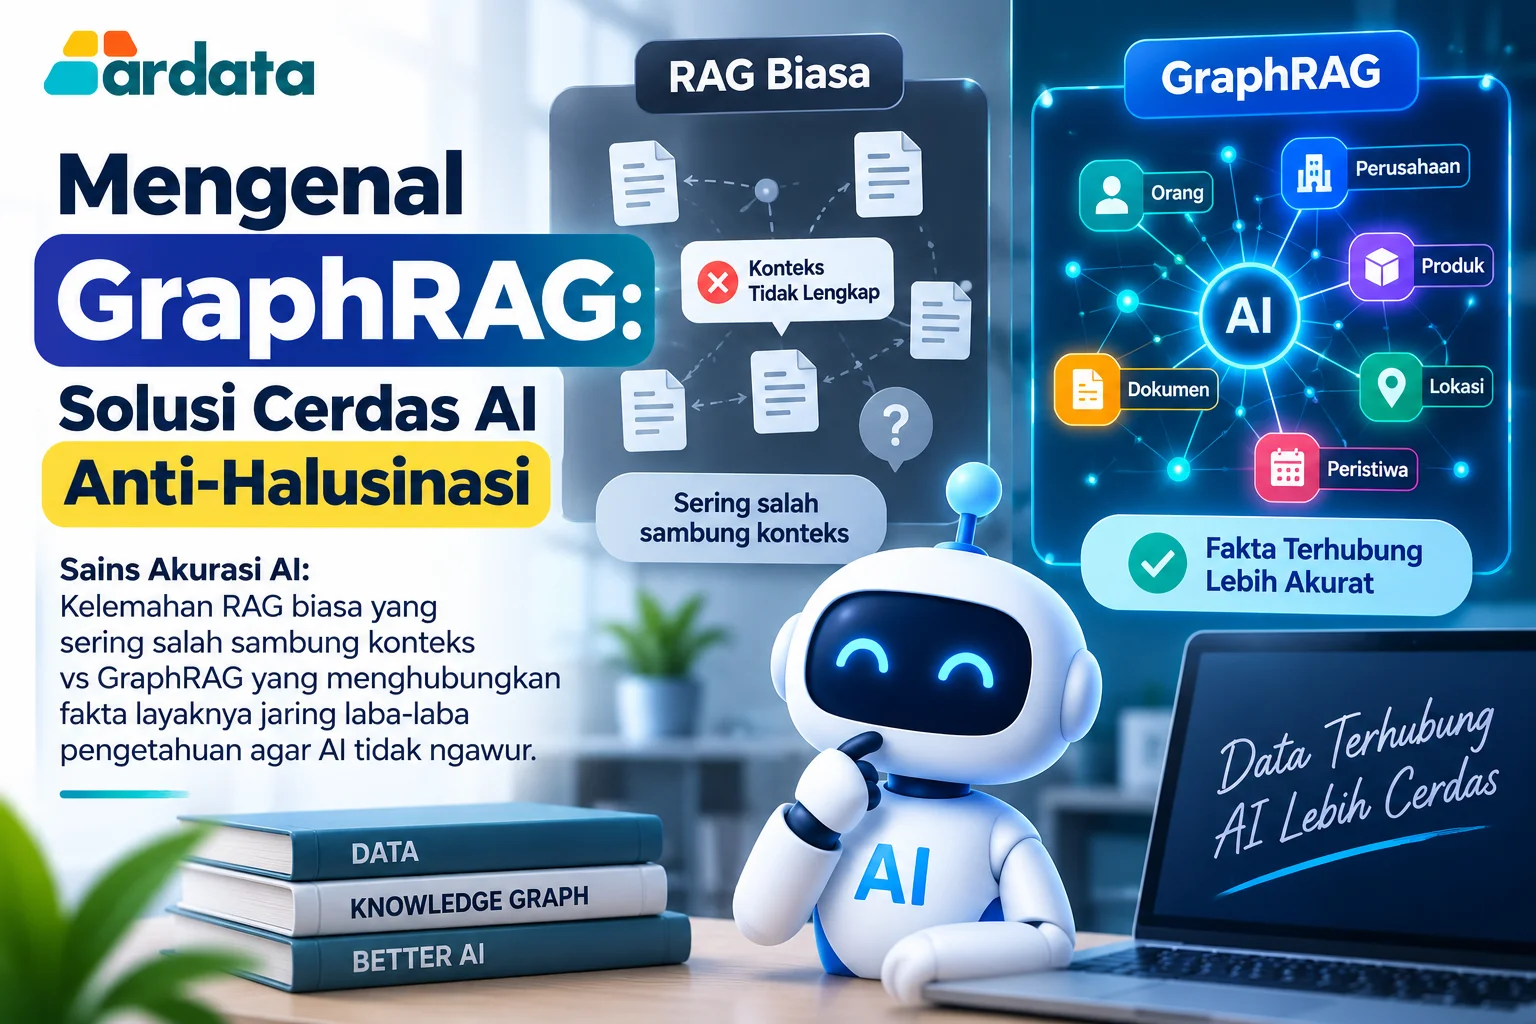
Artificial Intelligence semakin pintar menjawab pertanyaan, merangkum dokumen, hingga menganalisis data perusahaan. Namun, ada satu masalah yang masih sering muncul: AI dapat memberikan jawaban yang terdengar meyakinkan, padahal konteksnya kurang tepat atau informasinya tidak didukung data yang tersedia.
Salah satu pendekatan populer untuk mengatasinya adalah Retrieval-Augmented Generation (RAG). RAG memungkinkan AI mencari informasi dari sumber eksternal terlebih dahulu sebelum menghasilkan jawaban.
Namun, RAG konvensional juga mempunyai keterbatasan. Ketika informasi tersebar di banyak dokumen dan jawabannya bergantung pada hubungan antara berbagai fakta, pencarian berdasarkan kemiripan teks saja belum tentu memberikan gambaran utuh.
Di sinilah GraphRAG menjadi menarik.
Alih-alih hanya mencari potongan teks yang mirip dengan pertanyaan, GraphRAG dapat membangun struktur seperti jaring laba-laba pengetahuan, tempat entitas dan hubungan antarinformasi dipetakan sehingga AI memperoleh konteks yang lebih terstruktur.
Apa Itu GraphRAG?
GraphRAG atau Graph-based Retrieval-Augmented Generation adalah pendekatan RAG yang memanfaatkan struktur graph untuk membantu proses pencarian dan penyusunan konteks bagi Large Language Model (LLM).
Dalam implementasi GraphRAG dari Microsoft Research, sistem menggabungkan ekstraksi teks, analisis jaringan, prompting LLM, dan summarization menjadi sebuah pipeline untuk memahami kumpulan data teks secara lebih kaya.
Jika RAG biasa dapat digambarkan seperti:
Pertanyaan → Cari potongan teks relevan → Berikan ke LLM → Jawaban
GraphRAG menambahkan pemahaman terhadap hubungan informasi:
Dokumen → Entitas → Relasi → Knowledge Graph → Retrieval → LLM → Jawaban
Bayangkan AI membaca ribuan dokumen perusahaan.
Di dalamnya terdapat nama karyawan, proyek, pelanggan, produk, transaksi, lokasi, dan berbagai kejadian.
RAG biasa cenderung mencari potongan teks yang secara semantik paling dekat dengan pertanyaan.
GraphRAG mencoba memahami:
Siapa terhubung dengan siapa?
Produk mana berhubungan dengan proyek tertentu?
Peristiwa apa berhubungan dengan perusahaan tersebut?
Informasi apa yang membentuk satu kelompok atau tema besar?
Hubungan tersebut kemudian membentuk sebuah jaringan pengetahuan.
Mengapa RAG Biasa Bisa Salah Konteks?
RAG sebenarnya sudah menjadi peningkatan besar dibanding meminta LLM menjawab hanya berdasarkan pengetahuan internalnya.
Masalahnya, retrieval tradisional umumnya bekerja dengan memecah dokumen menjadi bagian-bagian kecil atau chunks, membuat representasi embedding, kemudian mencari chunks yang paling mirip dengan pertanyaan.
Pendekatan tersebut sangat berguna untuk pertanyaan sederhana dan spesifik.
Misalnya:
“Berapa lama masa garansi Produk A?”
Jika informasi tersebut terdapat jelas dalam sebuah dokumen, pencarian semantik kemungkinan dapat menemukan bagian yang relevan.
Masalah mulai muncul ketika pertanyaannya berbentuk:
“Apa masalah utama yang menyebabkan penjualan perusahaan menurun selama setahun terakhir?”
Jawabannya mungkin tidak berada dalam satu paragraf.
Fakta A terdapat pada laporan pemasaran.
Fakta B berada pada laporan penjualan.
Fakta C muncul dalam laporan distribusi.
Fakta D tercantum dalam feedback pelanggan.
RAG biasa dapat menemukan beberapa potongan informasi, tetapi belum tentu memahami hubungan yang mengikat semua fakta tersebut.
Dokumentasi Microsoft bahkan menjelaskan bahwa baseline RAG mengalami kesulitan pada pertanyaan yang membutuhkan agregasi informasi dari keseluruhan dataset, misalnya mencari tema utama dalam sekumpulan dokumen.
GraphRAG Mengubah Dokumen Menjadi Jaringan Pengetahuan
Inilah perbedaan penting GraphRAG.
Microsoft GraphRAG mempunyai pipeline indexing yang dirancang untuk mengekstrak entities, relationships, dan claims dari teks tidak terstruktur. Sistem kemudian melakukan community detection, membuat ringkasan komunitas pada beberapa tingkat, dan membuat embedding teks.
Bayangkan terdapat informasi:
Andi → bekerja pada → Perusahaan X
Perusahaan X → mengembangkan → Produk Y
Produk Y → digunakan oleh → Pelanggan Z
Pelanggan Z → melaporkan → Masalah A
Jika informasi tersebut hanya disimpan sebagai potongan teks terpisah, hubungan keseluruhannya tidak selalu terlihat.
Dalam graph, hubungan itu dapat direpresentasikan sebagai:
Andi → Perusahaan X → Produk Y → Pelanggan Z → Masalah A
Inilah alasan analogi “jaring laba-laba pengetahuan” cukup tepat.
Setiap titik merupakan informasi atau entitas, sedangkan garis menghubungkan hubungan di antara entitas tersebut.
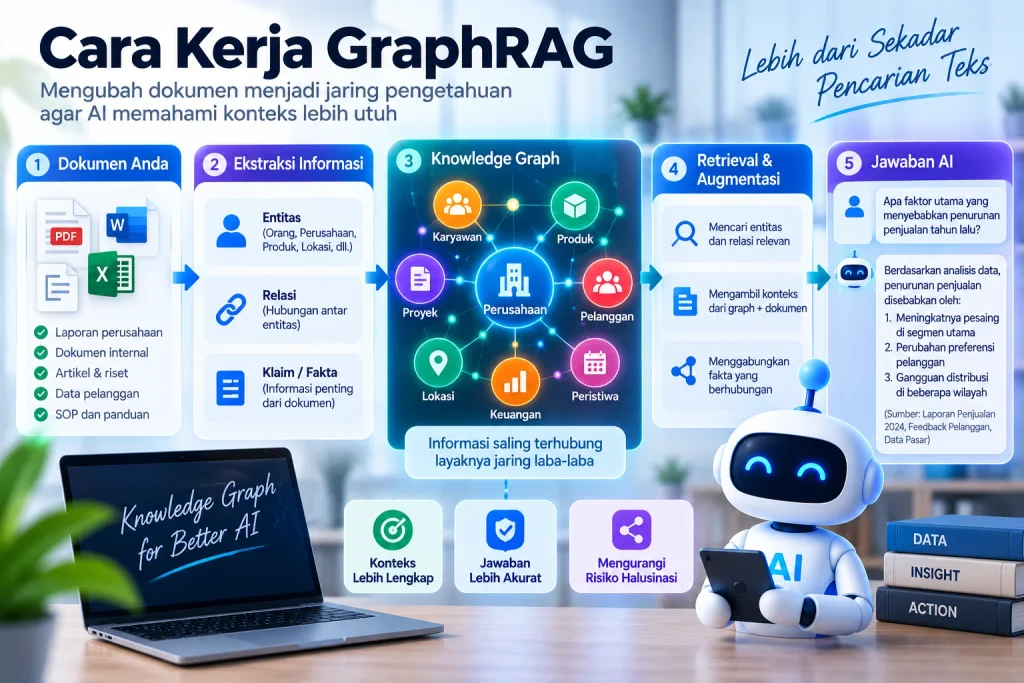
Bagaimana Cara Kerja GraphRAG?
Secara sederhana, pipeline GraphRAG dapat dipahami melalui beberapa tahap.
1. Memecah Dokumen
Dokumen terlebih dahulu dipecah menjadi unit teks yang dapat dianalisis.
Microsoft GraphRAG menyebut bagian ini sebagai TextUnits.
TextUnits menjadi unit dasar yang kemudian dianalisis lebih lanjut oleh pipeline.
2. Mengekstrak Entitas
AI kemudian mengidentifikasi entitas penting.
Misalnya:
Orang: Andi
Perusahaan: Ardata Tech
Produk: Aplikasi X
Lokasi: Jakarta
Proyek: Digitalisasi Data
Sistem tidak berhenti pada identifikasi nama tersebut.
3. Mengekstrak Hubungan
GraphRAG juga mencari relationship di antara entitas.
Contohnya:
Andi → mengelola → Proyek Digitalisasi
Proyek Digitalisasi → menggunakan → Aplikasi X
Aplikasi X → dikembangkan oleh → Ardata Tech
Hasilnya mulai menyerupai knowledge graph.
4. Membentuk Community
GraphRAG kemudian mengelompokkan entitas yang saling berhubungan ke dalam community.
Microsoft GraphRAG menggunakan hierarchical clustering sehingga graph dapat dibagi menjadi kelompok-kelompok informasi yang saling berkaitan.
Contohnya:
Community A: Produk dan pelanggan
Community B: Keuangan dan transaksi
Community C: Karyawan dan proyek
Community D: Distribusi dan supplier
5. Membuat Community Summary
Setiap community kemudian dapat diringkas.
Artinya, ketika pengguna menanyakan gambaran besar sebuah dataset, AI tidak harus bergantung hanya pada beberapa paragraf yang kebetulan mempunyai embedding mirip.
Ia dapat memanfaatkan struktur dan ringkasan dari kelompok informasi tersebut.
RAG Biasa vs GraphRAG
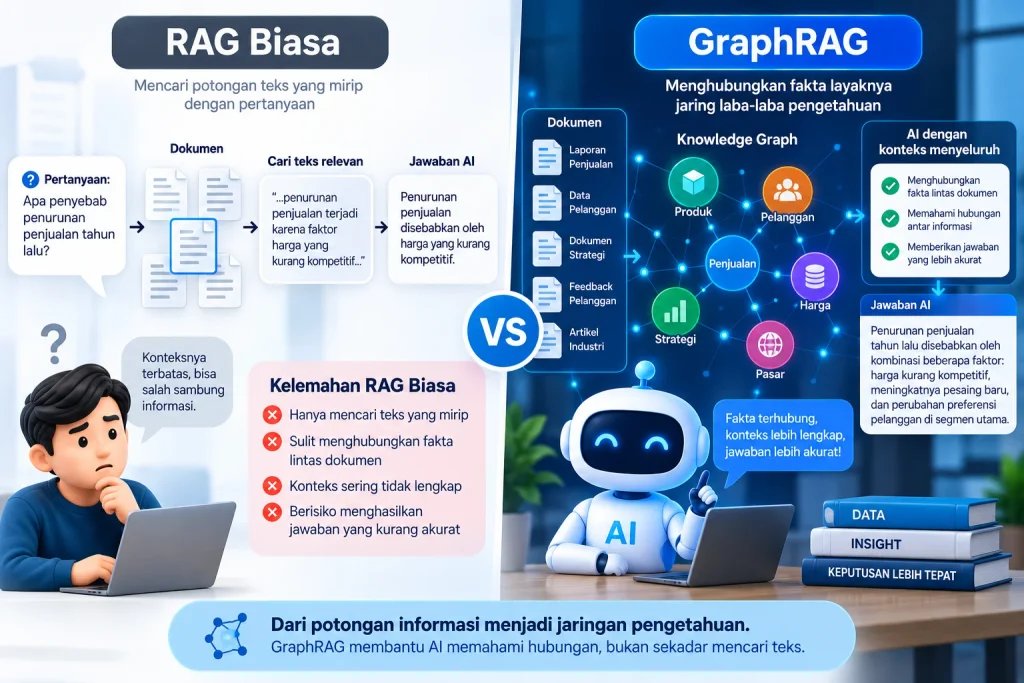
Perbedaannya dapat disederhanakan seperti berikut:
| Aspek | RAG Biasa | GraphRAG |
|---|---|---|
| Struktur utama | Text chunks | Graph + text |
| Retrieval | Kemiripan semantik | Entitas, relasi, graph, dan konteks |
| Hubungan antarfakta | Lebih terbatas | Lebih kuat |
| Pertanyaan spesifik | Sangat cocok | Cocok |
| Pertanyaan lintas dokumen | Bisa kesulitan | Lebih potensial |
| Pertanyaan global dataset | Terbatas | Salah satu kekuatan utama |
| Kompleksitas implementasi | Relatif sederhana | Lebih kompleks |
| Biaya indexing | Relatif lebih ringan | Dapat lebih tinggi |
GraphRAG bukan berarti selalu mengalahkan RAG biasa. Evaluasi akademis menunjukkan keduanya mempunyai kekuatan berbeda tergantung tugas dan karakteristik datanya.
Jadi untuk pertanyaan sederhana, menggunakan GraphRAG bisa saja berlebihan.
Local Search: Menelusuri Fakta Spesifik
Microsoft GraphRAG menyediakan beberapa mekanisme query.
Salah satunya adalah Local Search.
Local Search menggabungkan data terstruktur dari knowledge graph dengan potongan teks asli. Sistem mencari entitas yang secara semantik berkaitan dengan pertanyaan, kemudian menggunakan entitas tersebut sebagai titik masuk untuk menemukan hubungan dan informasi terkait.
Misalnya pengguna bertanya:
“Apa hubungan Produk X dengan Perusahaan Y?”
GraphRAG dapat menemukan Produk X sebagai sebuah entitas, kemudian menelusuri hubungan yang relevan dan mengambil potongan dokumen pendukung.
Metode ini cocok ketika pertanyaan berpusat pada entitas tertentu.
Global Search: Melihat Gambaran Besar
Fitur yang membuat GraphRAG menarik adalah Global Search.
Bayangkan perusahaan mempunyai 10.000 laporan pelanggan.
Kemudian direktur bertanya:
“Apa tiga masalah terbesar yang paling sering muncul dari pelanggan tahun ini?”
Tidak ada satu paragraf yang secara langsung menjawab pertanyaan tersebut.
RAG biasa harus menemukan beberapa chunks yang dianggap relevan.
GraphRAG dapat memanfaatkan community reports dari graph untuk memahami dataset secara lebih menyeluruh. Global Search kemudian mengolah informasi tersebut menggunakan pendekatan map-reduce untuk menghasilkan jawaban.
Pendekatan ini memang dirancang untuk pertanyaan yang membutuhkan pemahaman terhadap dataset secara keseluruhan.
DRIFT Search: Menggabungkan Lokal dan Global
GraphRAG juga mempunyai metode DRIFT Search.
Pendekatan ini memperluas Local Search dengan memasukkan informasi community sebagai bagian dari proses pencarian.
Tujuannya adalah memperluas titik awal retrieval dan menghasilkan pertanyaan lanjutan yang lebih detail sehingga lebih banyak fakta relevan dapat ditemukan.
Dengan demikian, pilihan query GraphRAG tidak sekadar satu metode.
Secara umum terdapat:
Local Search → fokus pada entitas tertentu.
Global Search → memahami gambaran keseluruhan dataset.
DRIFT Search → memperluas pencarian lokal dengan informasi community.
GraphRAG juga menyediakan Basic Search sebagai implementasi vector RAG sederhana untuk perbandingan.
Apakah GraphRAG Benar-Benar Membuat AI Anti-Halusinasi?
Jawabannya: tidak sepenuhnya.
Istilah “AI anti-halusinasi” sebaiknya dipahami sebagai penyederhanaan.
GraphRAG tidak memberikan jaminan bahwa LLM tidak akan pernah menghasilkan informasi keliru.
Yang dilakukan GraphRAG adalah meningkatkan kualitas context retrieval dengan mempertimbangkan struktur dan hubungan informasi.
Semakin relevan dan terstruktur konteks yang diberikan kepada LLM, semakin besar peluang model menghasilkan jawaban yang didukung data.
Namun kesalahan masih dapat muncul dari proses ekstraksi entitas, pembentukan hubungan, kualitas dokumen sumber, retrieval, maupun proses generation oleh LLM.
Bahkan dokumentasi Global Search Microsoft memperingatkan bahwa mengizinkan model memasukkan general knowledge di luar dataset dapat meningkatkan risiko hallucination.
Jadi klaim yang lebih tepat adalah:
GraphRAG membantu mengurangi salah konteks dan meningkatkan grounding AI, bukan menghapus halusinasi 100%.
Contoh Penggunaan GraphRAG di Dunia Nyata
GraphRAG berpotensi berguna pada kumpulan informasi yang mempunyai banyak hubungan kompleks.
Contohnya adalah knowledge management perusahaan.
Perusahaan mempunyai ribuan SOP, laporan proyek, kontrak, dokumen operasional, dan catatan lainnya. GraphRAG dapat membantu menghubungkan entitas serta hubungan yang tersebar di antara dokumen tersebut.
Contoh lainnya adalah riset ilmiah.
Sebuah sistem dapat memetakan hubungan antara penelitian, konsep, temuan, metode, dan topik sehingga peneliti dapat mengeksplorasi pola yang lebih luas.
GraphRAG juga relevan untuk analisis dokumen hukum, analisis bisnis, customer intelligence, riset pasar, software documentation, hingga sistem pencarian internal perusahaan.
Kelebihan GraphRAG
Keunggulan terbesar GraphRAG bukan sekadar menemukan teks.
Teknologi ini mencoba memahami struktur pengetahuan di balik teks tersebut.
Beberapa keunggulannya meliputi kemampuan menghubungkan fakta lintas dokumen, memahami hubungan antarinformasi, menjawab pertanyaan global, menyediakan konteks yang lebih terstruktur, serta membantu eksplorasi dataset kompleks.
Penelitian awal Microsoft terhadap pertanyaan global pada dataset sekitar satu juta token menunjukkan GraphRAG memberikan peningkatan substansial dibanding naive RAG dalam aspek comprehensiveness dan diversity jawaban pada kelas pertanyaan yang diuji.
Namun hasil tersebut tidak berarti GraphRAG otomatis lebih baik untuk seluruh kasus penggunaan.
Kekurangan GraphRAG yang Perlu Diketahui
Kemampuan tambahan tersebut mempunyai konsekuensi.
GraphRAG membutuhkan proses indexing yang lebih kompleks karena sistem harus mengekstrak entitas dan hubungan, membentuk graph, melakukan community detection, membuat summary, dan menyimpan representasi yang diperlukan.
Dokumentasi resminya bahkan memperingatkan bahwa GraphRAG dapat menggunakan sumber daya LLM dalam jumlah besar dan menyarankan pengguna memulai dari dataset kecil serta model yang lebih murah.
Karena itu, untuk chatbot FAQ dengan dokumen sederhana, RAG biasa mungkin lebih ekonomis.
GraphRAG menjadi lebih menarik ketika hubungan antar-data merupakan bagian penting dari jawaban.
RAG atau GraphRAG, Mana yang Sebaiknya Digunakan?
Tidak semua aplikasi AI membutuhkan GraphRAG.
Gunakan RAG biasa ketika pertanyaan sebagian besar sederhana, informasi dapat ditemukan langsung dalam beberapa dokumen, hubungan antar-entitas tidak terlalu kompleks, dan biaya serta kecepatan menjadi prioritas.
Pertimbangkan GraphRAG ketika data tersebar di banyak dokumen, terdapat banyak entitas yang saling berhubungan, pengguna sering mengajukan pertanyaan lintas dokumen, atau aplikasi harus memahami pola dan tema dari dataset secara keseluruhan.
Penelitian yang lebih baru pada 2026 juga menunjukkan bahwa sistem GraphRAG dan RAG tingkat lanjut perlu dipilih berdasarkan skenario; retrieval yang semakin luas tidak otomatis menghasilkan kualitas generation yang meningkat secara proporsional.
Artinya, lebih kompleks tidak selalu berarti lebih baik.
GraphRAG dan Masa Depan AI yang Lebih Akurat
Perkembangan AI tidak hanya bergantung pada model yang semakin besar.
Cara kita memberikan konteks yang benar kepada model sama pentingnya.
RAG membawa perubahan besar dengan memungkinkan AI mencari informasi eksternal sebelum menjawab. GraphRAG membawa konsep tersebut satu langkah lebih jauh dengan mencoba memahami hubungan di antara informasi.
Dari:
“Cari teks yang mirip.”
menjadi:
“Cari fakta, pahami hubungan, lalu bangun konteks.”
Perubahan tersebut penting untuk aplikasi AI yang harus bekerja dengan informasi perusahaan, riset, dokumen panjang, atau kumpulan pengetahuan kompleks.
GraphRAG merupakan pendekatan Retrieval-Augmented Generation yang memanfaatkan struktur graph untuk menghubungkan entitas, hubungan, dan informasi dari kumpulan data.
Jika RAG biasa seperti mencari beberapa halaman paling relevan dari tumpukan dokumen, GraphRAG lebih menyerupai membuat peta atau jaring laba-laba pengetahuan yang menunjukkan bagaimana fakta-fakta tersebut saling terhubung.
Keunggulan ini membuat GraphRAG menarik untuk pertanyaan kompleks, analisis lintas dokumen, dan pemahaman dataset secara keseluruhan.
Namun, GraphRAG bukan tombol ajaib “anti-halusinasi”. Kualitas sumber, proses indexing, retrieval, dan model yang digunakan tetap menentukan kualitas akhir.
Karena itu, cara paling tepat melihat GraphRAG bukan sebagai pengganti mutlak RAG biasa, melainkan sebagai evolusi retrieval untuk kasus ketika hubungan antar-fakta sama pentingnya dengan fakta itu sendiri.
